
שאלו את שאלתכם וקבלו סיכום של המסמך על ידי הפניה לדף הזה ולספק ה-AI שתבחרו
התוכן של הדף הזה תורגם באמצעות AI.
צפייה בגרסה האחרונה של התוכן המקורי באנגליתאם יש לכם רעיון לשיפור התיעוד הזה, אל תהססו לתרום על ידי הגשת Pull Request ב-GitHub.
קישור GitHub לתיעודהעתקת ה-Markdown של המסמך ללוח
i18n לפי-רכיב (Per-Component) מול גישה מרוכזת (Centralized)
גישת ה-per-component אינה מושג חדש. לדוגמה, באקוסיסטם של Vue, הספרייה vue-i18n תומכת ב-Single File Component (SFC) i18n. גם Nuxt מציעה תרגומים לפי רכיב, ו-Angular משתמשת בתבנית דומה באמצעות Feature Modules.
אפילו באפליקציות Flutter, ניתן למצוא לעתים קרובות את התבנית הזו:
העתקת הקוד ללוח
העתקת הקוד ללוח
עם זאת, בעולם של React אנו רואים בעיקר גישות שונות, אותן ניתן לחלק לשתי קטגוריות עיקריות:
גישה מרוכזת (Centralized approach) (i18next, next-intl, react-intl, lingui)
- (ללא namespaces) מסתמכת על מקור יחיד לשליפת תוכן. כברירת מחדל, אתם טוענים את התוכן של כל הדפים כאשר האפליקציה נטענת.
גישה מגורענת (Granular approach) (intlayer, inlang)
- מחלקת את שליפת התוכן ברזולוציה עדינה לפי מפתח, או לפי רכיב (per-component).
במאמר זה לא אתמקד בפתרונות מבוססי קומפיילר, אותם כבר סקרתי כאן: קומפיילר מול i18n הצהרתי. שימו לב ש-i18n מבוסס קומפיילר (למשל Lingui) פשוט הופך את החילוץ והטעינה של התוכן לאוטומטיים. מתחת למכסה המנוע, פתרונות אלו חולקים לרוב את אותן מגבלות כמו שאר הגישות.
שימו לב שככל ששליפת התוכן מגורענת יותר, כך גובר הסיכון להחדרת state ולוגיקה נוספים לתוך הרכיבים שלכם.
גישות מגורענות גמישות יותר מגישות מרוכזות, אך לרוב מדובר בפשרה (tradeoff). גם אם ספריות מסוימות מפרסמות "tree shaking", בפועל לעתים קרובות תסיימו בטעינת הדף בכל השפות.
באופן כללי, ההחלטה מתמצתת כך:
- יותר דפים משפות ← העדיפו גישה מגורענת (granular)
- יותר שפות מדפים ← העדיפו גישה מרוכזת (centralized)
כמובן שמפתחי הספריות מודעים למגבלות אלו ומספקים מעקפים.
ביניהם: חלוקה ל-namespaces, טעינה דינמית של קובצי JSON באמצעות (await import()), או הסרת תוכן לא בשימוש (purging) בזמן הבנייה (build time).
הנה מה שכל בחירה עולה באפליקציה תיאורטית של 1 עד 10 דפים ב-1 עד 10 שפות, עם כ-30KB של טקסט לכל דף. ייבוא דינמי חותך את ציר השפות, תיחום (scoping) חותך את ציר הדפים, ורק השילוב ביניהם שומר על גרף שטוח ויציב.
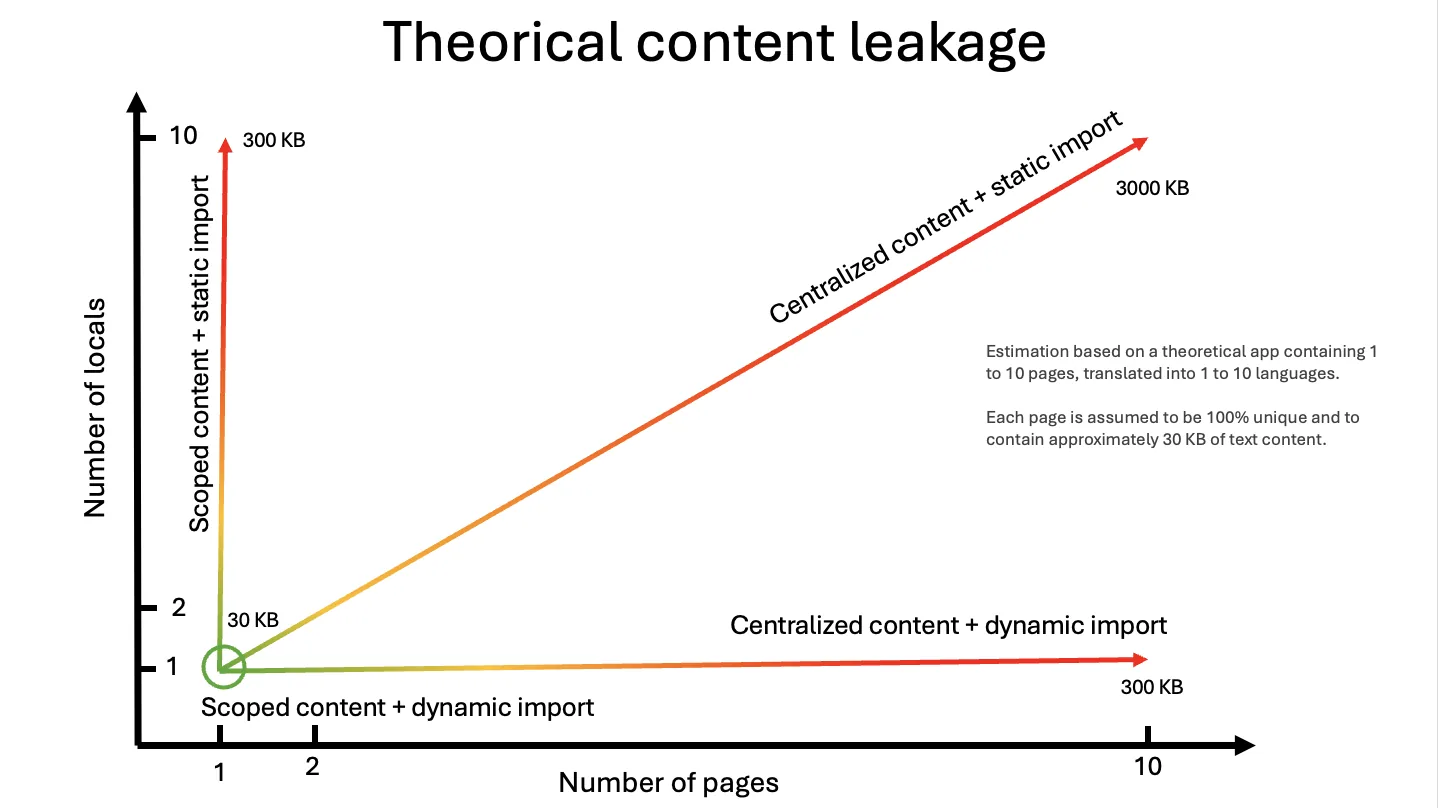
במקביל, עליכם לדעת שכאשר אתם טוענים תוכן באופן דינמי, אתם מייצרים בקשות רשת נוספות לשרת שלכם. כל useState או hook נוסף עשויים לגרור בקשת שרת נוספת.
כדי לפתור נקודה זו, Intlayer מציעה לקבץ הגדרות תוכן מרובות תחת אותו מפתח, ו-Intlayer תמזג את התוכן הזה באופן אוטומטי.
אך מבין כל הפתרונות הללו, ברור שהגישה הפופולרית ביותר היא עדיין הגישה המרוכזת.
מדוע הגישה המרוכזת כה פופולרית?
- ראשית, i18next הייתה הפתרון הראשון שזכה לאימוץ נרחב, לפי פילוסופיה בהשראת ארכיטקטורות PHP ו-Java (MVC), הנשענות על הפרדת רשויות קפדנית (separation of concerns, הפרדת תוכן מקוד). היא הופיעה בשנת 2011 וקבעה סטנדרטים עוד לפני המעבר המאסיבי לארכיטקטורות מבוססות רכיבים (כמו React).
- שנית, ברגע שספרייה מאומצת בהיקף כה רחב, קשה להזיז את האקוסיסטם לתבניות אחרות.
- שימוש בגישה מרוכזת גם מקל על העבודה במערכות ניהול תרגום (TMS) כגון Crowdin, Phrase או Localise.
- הלוגיקה מאחורי גישת per-component מורכבת יותר מזו של גישה מרוכזת ודורשת זמן פיתוח נוסף, במיוחד כאשר צריך לפתור בעיות כמו זיהוי מיקום התוכן.
כדי להבין מהיכן הגיעו ספריות אלו, קראו על ההיסטוריה של i18n ב-JavaScript.
טוב, אז למה לא פשוט להישאר עם הגישה המרוכזת?
הנה הסיבות מדוע גישה זו עלולה להיות בעייתית עבור האפליקציה שלכם:
- מידע שאינו בשימוש (Unused Data): כאשר דף נטען, לעתים קרובות אתם טוענים את התוכן של כל שאר הדפים. (באפליקציה של 10 דפים, מדובר ב-90% תוכן מיותר שנטען). טוענים חלון מודאלי ב-lazy loading? ספריית ה-i18n אינה מתחשבת בכך, היא תטען את המחרוזות קודם לכן בכל מקרה.
- ביצועים (Performance): בכל re-render, כל רכיב ורכיב עובר הידרציה עם מטען JSON כבד, מה שפוגע בתגובתיות האפליקציה ככל שהיא גדלה.
- תחזוקה (Maintenance): תחזוקת קובצי JSON ענקיים היא משימה מייגעת. עליכם לקפוץ בין קבצים שונים כדי להכניס תרגום, לוודא שלא חסרים תרגומים ושלא נותרו מפתחות יתומים (orphan keys) מאחור.
- Design System:
הדבר יוצר חוסר התאמה למערכות עיצוב (למשל רכיב
LoginForm) ומגביל שימוש חוזר ברכיבים בין אפליקציות שונות.
"אבל המצאנו Namespaces!"
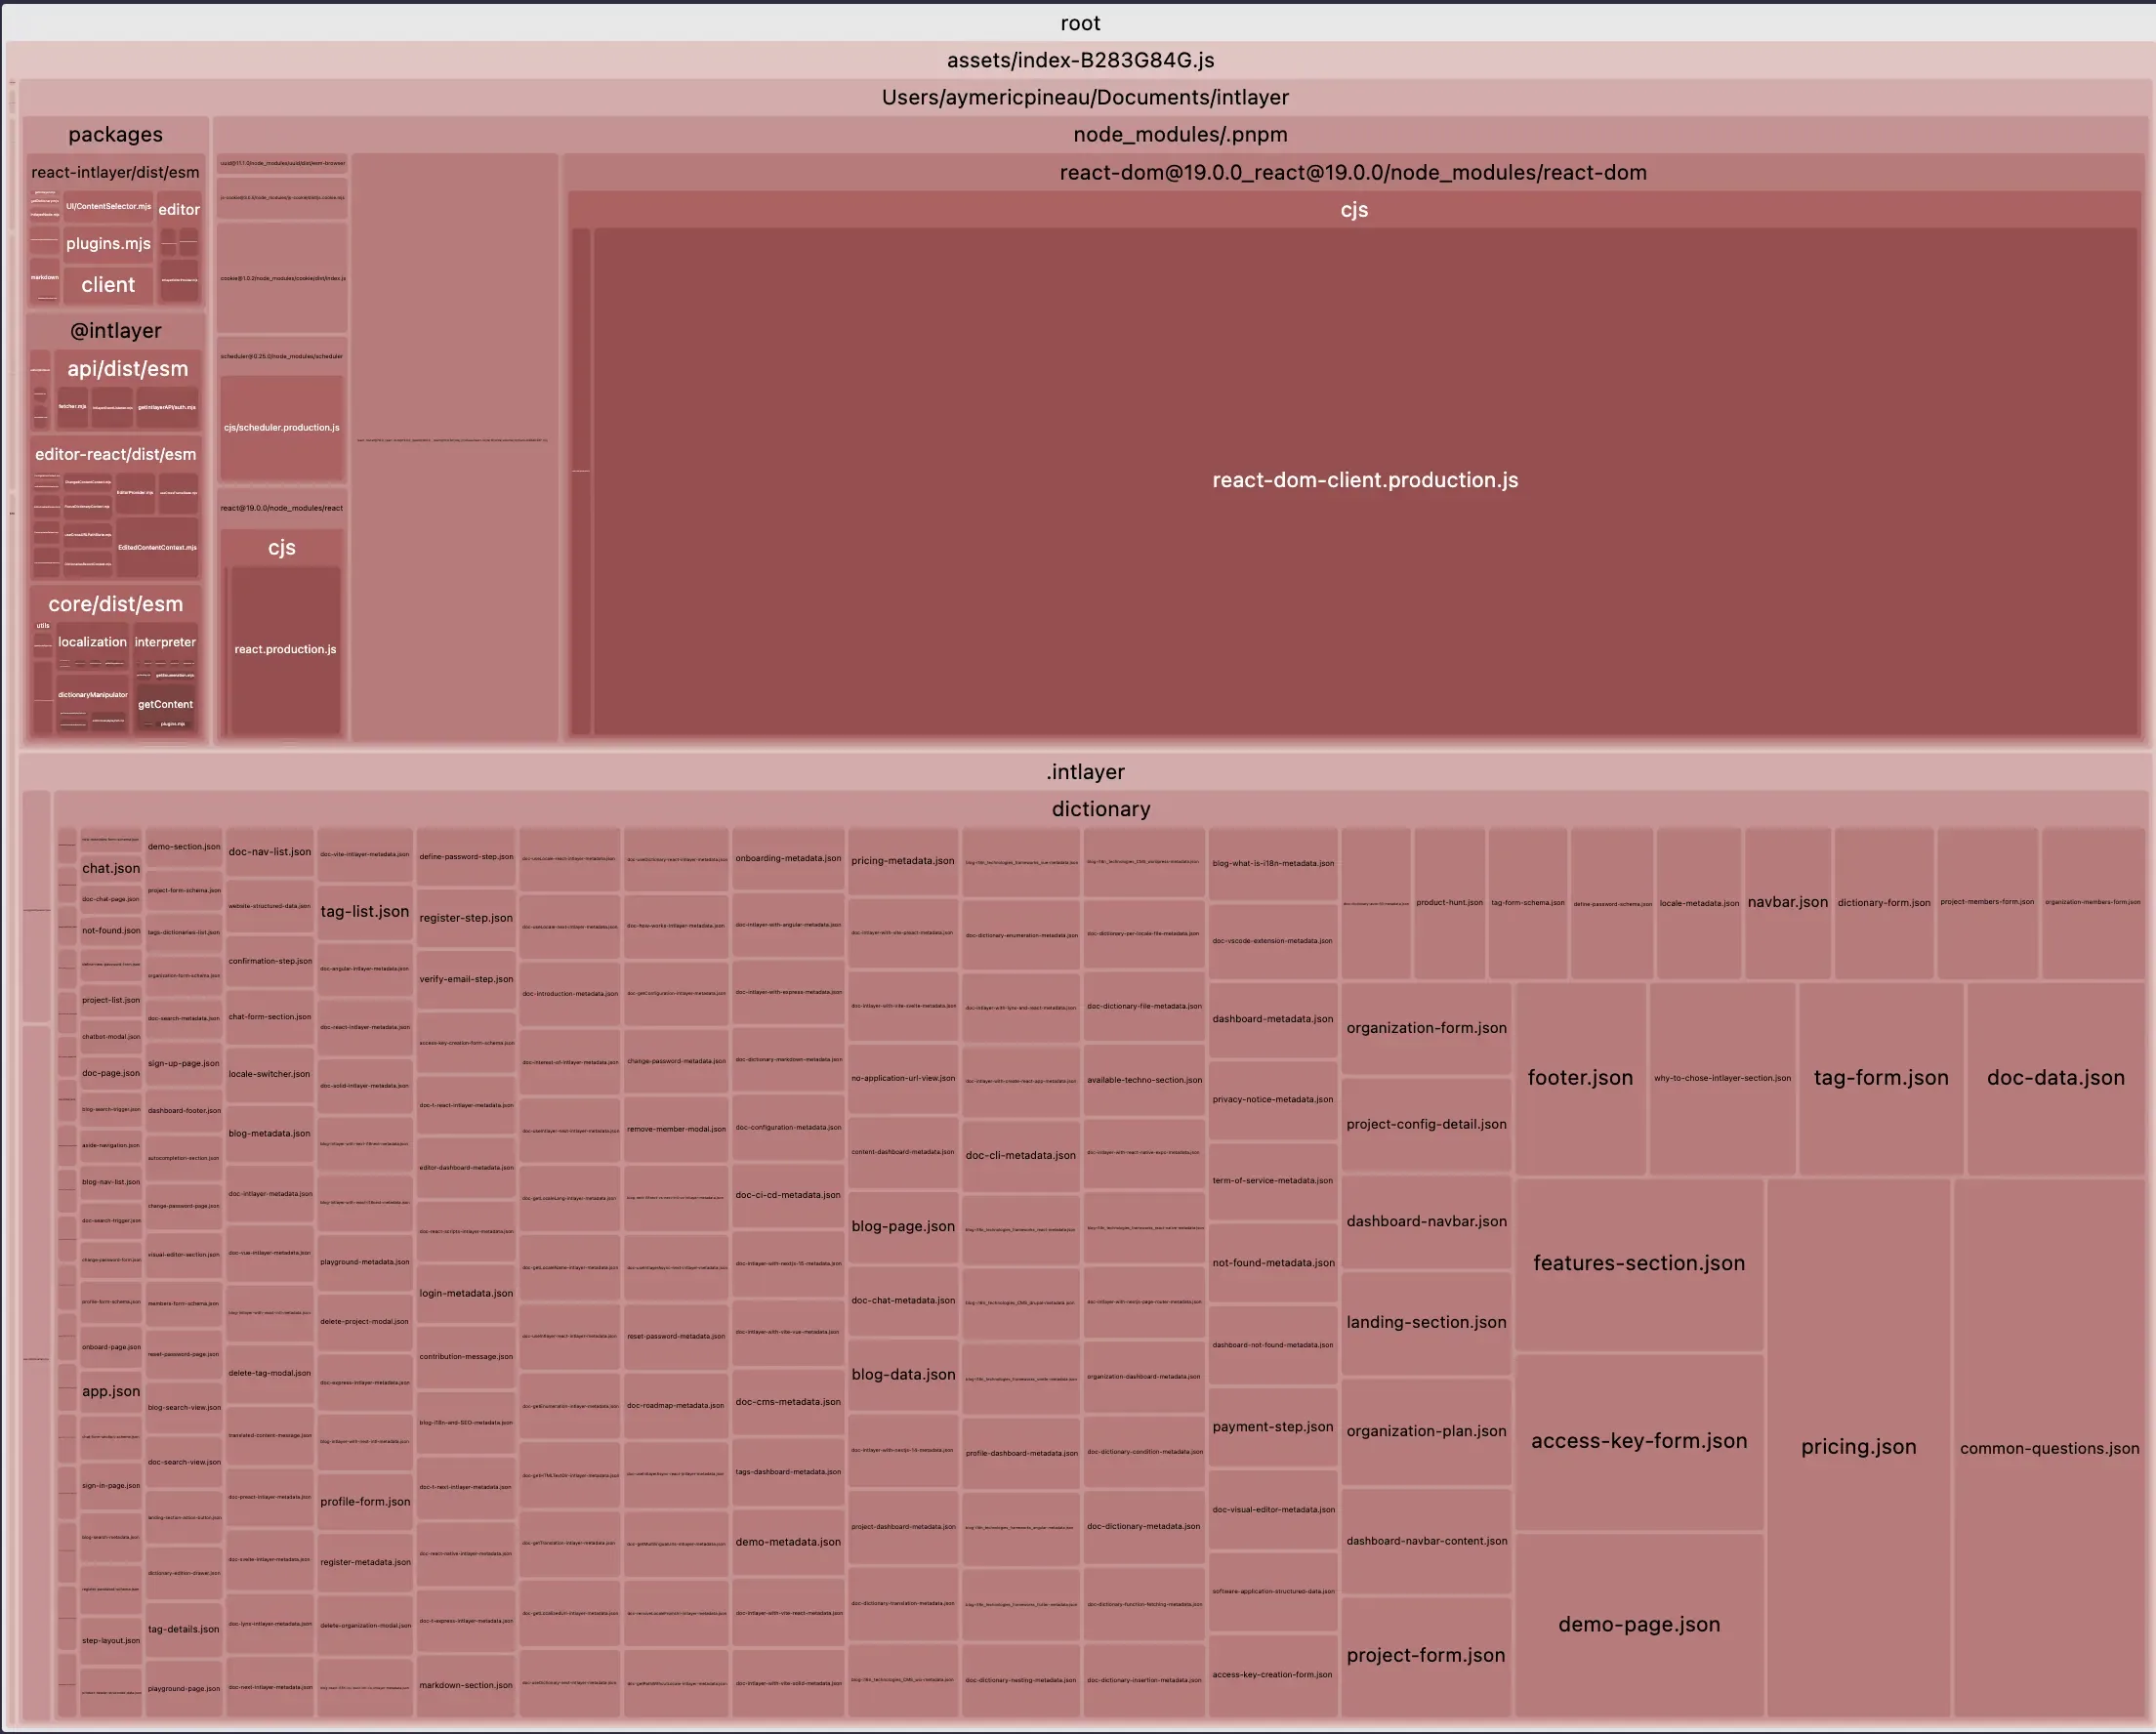
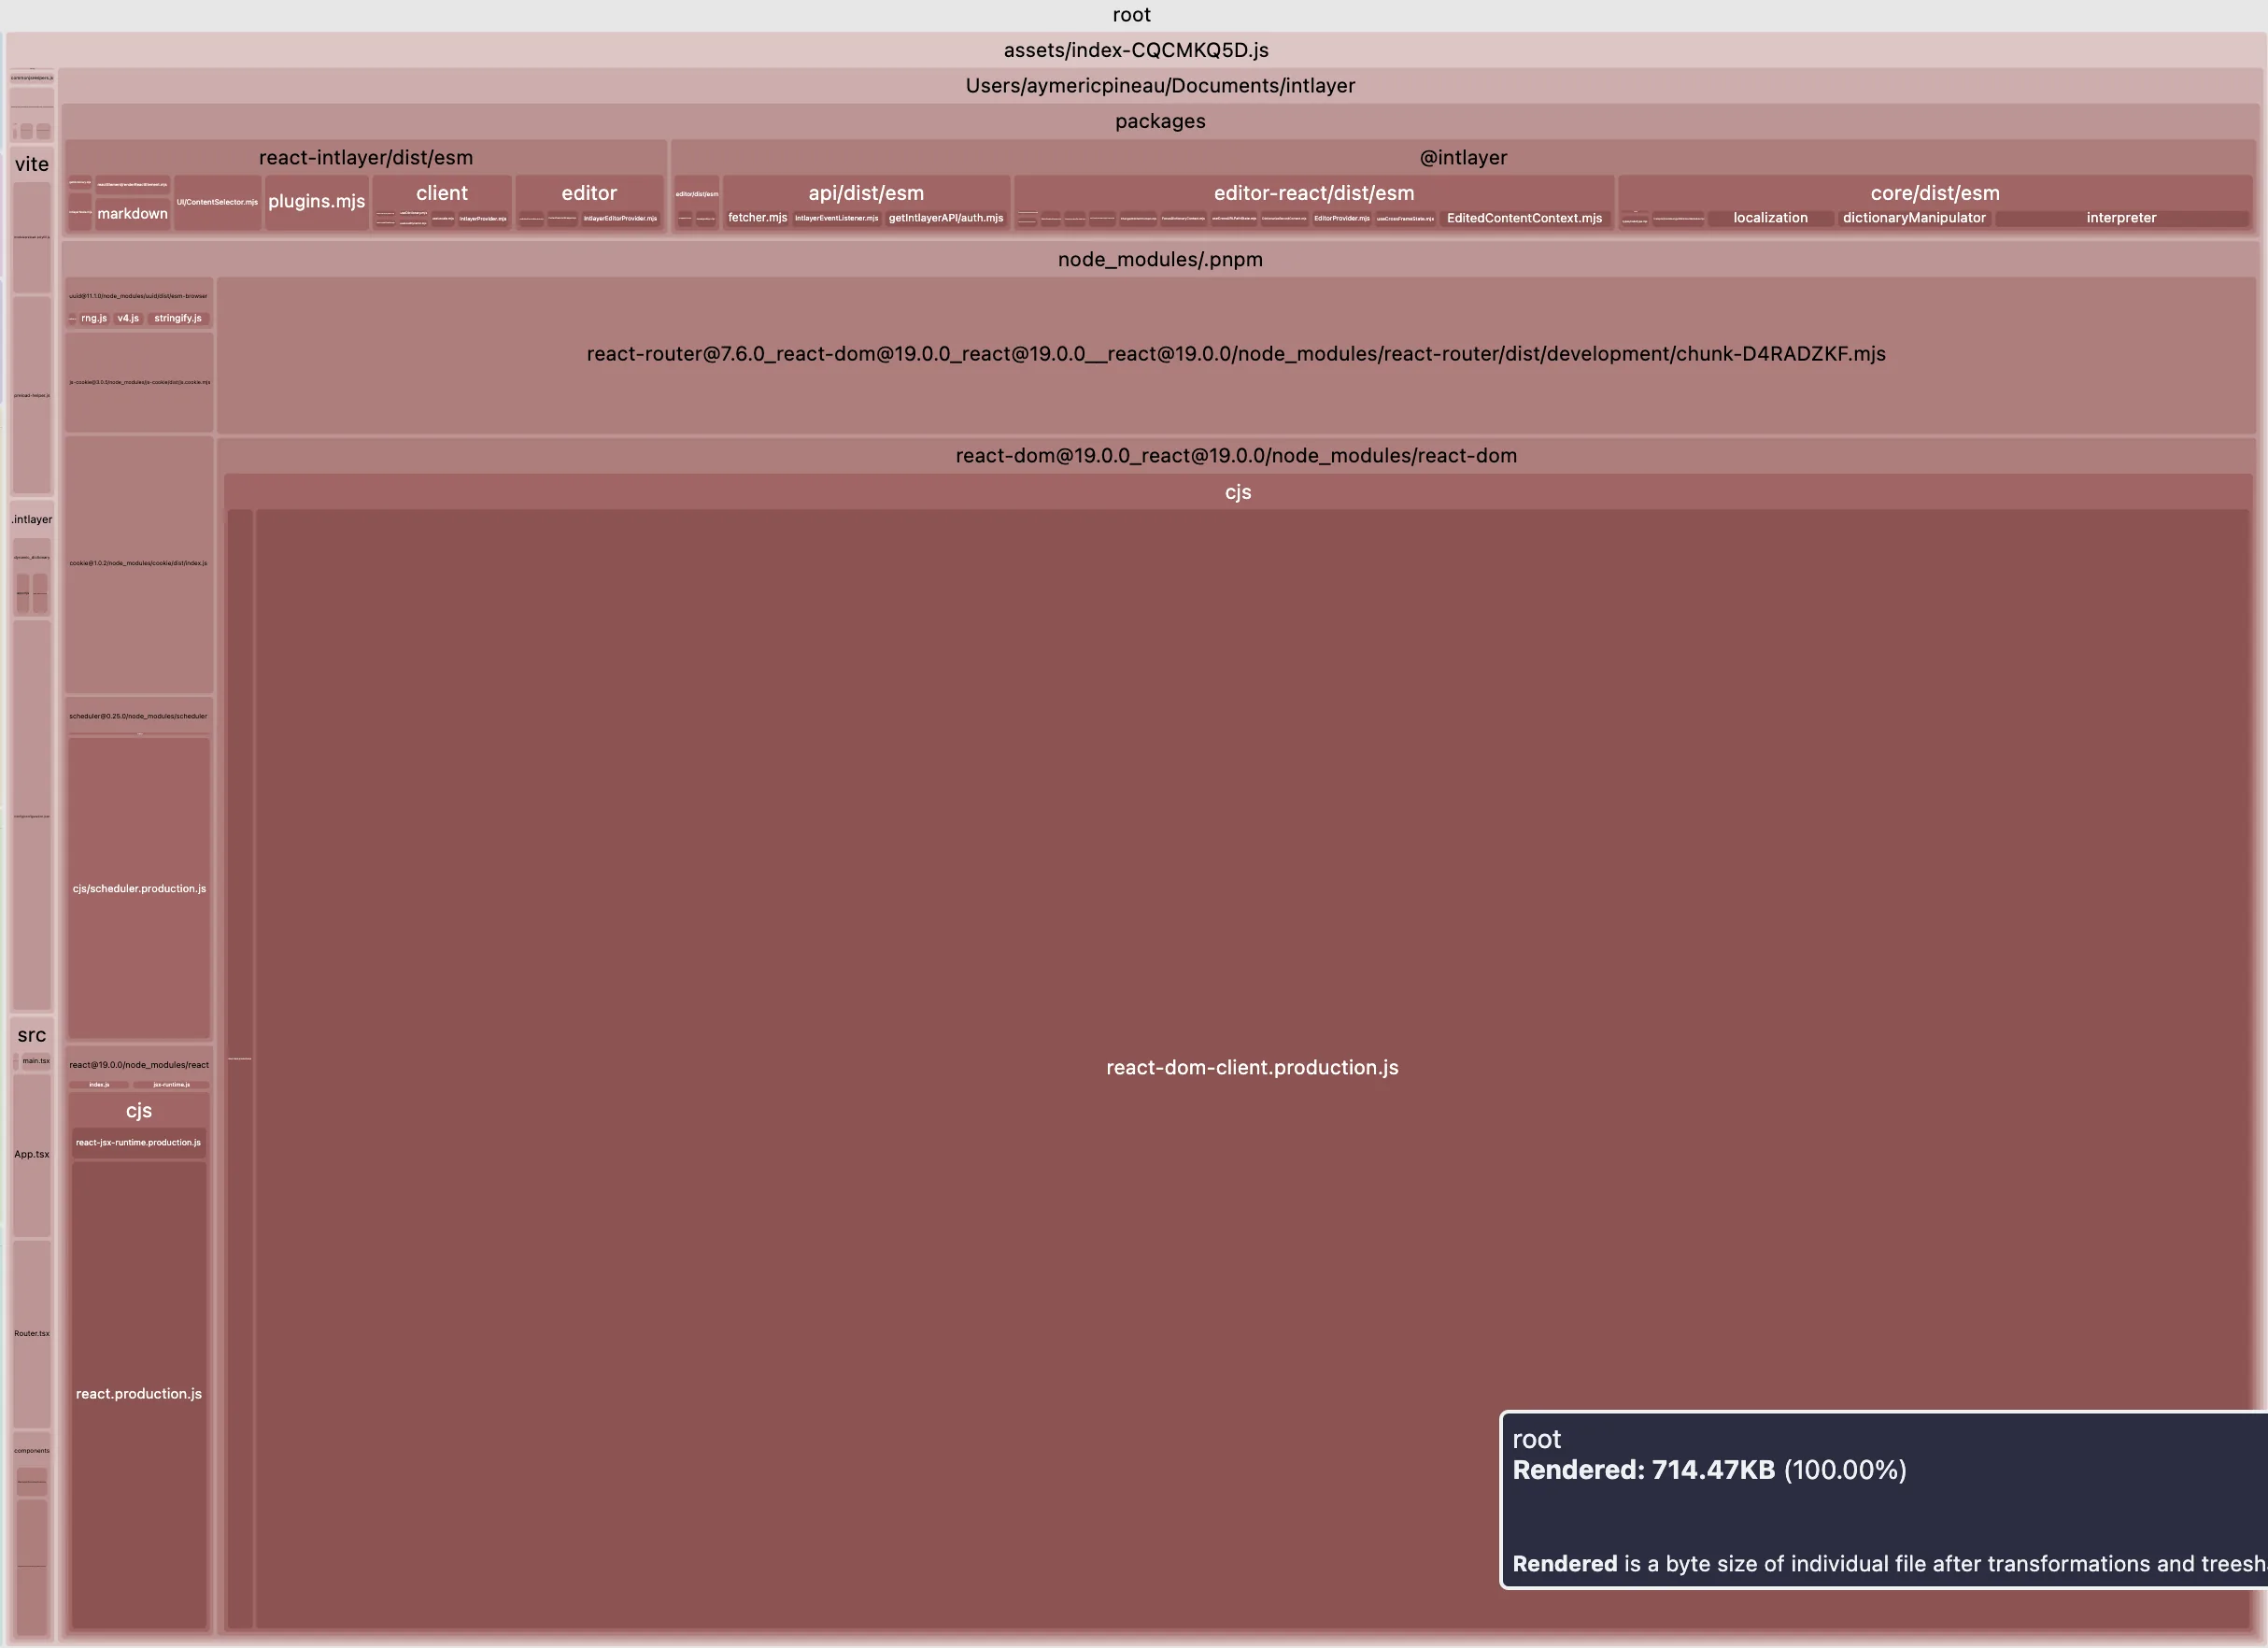
נכון, וזהו צעד משמעותי קדימה. בואו נבחן את השוואת גודל החבילה הראשית (main bundle size) בסביבת Vite + React + React Router v7 + Intlayer. ביצענו סימולציה לאפליקציה בת 20 דפים.
הדוגמה הראשונה אינה כוללת טעינה עצלה (lazy loading) של תרגומים לכל שפה וללא פיצול ל-namespaces. השנייה כוללת purging של תוכן וטעינה דינמית של תרגומים.
פתיחת הטבלה בחלון כדי לראות את כל תוכן הנתונים בבירור
| חבילה מותאמת (Optimized bundle) | חבילה שאינה מותאמת (Bundle not optimized) |
|---|---|
 |  |
הודות ל-namespaces, עברנו ממבנה כזה:
העתקת הקוד ללוח
למבנה כזה:
העתקת הקוד ללוח
מצוין, אך האם זה מספיק? לא ממש. כעת עליכם לנהל באופן ידני ומדוקדק איזה חלק מתוכן האפליקציה ייטען, והיכן. המסקנה היא שרוב הפרויקטים פשוט מדלגים על חלק זה בגלל המורכבות (ראו מדריך next-i18next למשל, כדי לראות את האתגרים שנובעים (רק) מיישום שיטות מומלצות). כתוצאה מכך, פרויקטים אלו מסיימים עם בעיית טעינת ה-JSON המאסיבית שתוארה קודם לכן.
שימו לב שבעיה זו אינה ייחודית ל-i18next, אלא לכל הגישות המרוכזות שהוזכרו לעיל.
עם זאת, חשוב לזכור שלא כל הגישות המגורענות פותרות זאת. לדוגמה, גישות כמו vue-i18n SFC או inlang אינן מבצעות כברירת מחדל lazy loading לתרגומים לפי שפה, כך שאתם פשוט מחליפים בעיית גודל חבילה אחת באחרת.
בנוסף, ללא הפרדת רשויות נאותה, הופך קשה בהרבה לחלץ ולספק את התרגומים למתרגמים לצורך בדיקה.
כיצד גישת ה-per-component של Intlayer פותרת זאת
Intlayer פועלת בכמה שלבים:
- הצהרה (Declaration): הגדירו את התוכן בכל מקום בקוד שלכם באמצעות קובצי
*.content.{ts|jsx|cjs|json|json5|...}. הדבר מבטיח הפרדת רשויות תוך שמירה על colocation של התוכן. קובץ תוכן יכול להיות לפי שפה בודדת או רב-לשוני. - עיבוד (Processing): Intlayer מריצה שלב בנייה כדי לעבד לוגיקת JS, לטפל בנסיגה (fallback) לתרגומים חסרים, לייצר טיפוסי TypeScript, לנהל תוכן כפול, למשוך תוכן מה-CMS שלכם ועוד.
- ניקוי (Purging): כאשר האפליקציה שלכם נבנית, Intlayer מנקה תוכן שאינו בשימוש (בדומה לאופן שבו Tailwind מנהלת מחלקות CSS) על ידי החלפת התוכן כדלקמן:
הצהרה:
העתקת הקוד ללוח
העתקת הקוד ללוח
עיבוד: Intlayer בונה את המילון בהתבסס על קובץ ה-.content ומייצרת:
העתקת הקוד ללוח
החלפה: Intlayer מחלצת את הרכיב שלכם במהלך בניית האפליקציה.
מצב ייבוא סטטי (Static Import Mode):
העתקת הקוד ללוח
מצב ייבוא דינמי (Dynamic Import Mode):
העתקת הקוד ללוח
useDictionaryAsync משתמש במנגנון דמוי Suspense כדי לטעון את ה-JSON המתורגם רק בעת הצורך.יתרונות מרכזיים בגישת per-component זו:
שמירת הצהרת התוכן בצמוד לרכיבים מאפשרת יכולת תחזוקה משופרת (למשל, העברת רכיב לאפליקציה אחרת או ל-design system. מחיקת תיקיית הרכיב מוחקת גם את התוכן הקשור אליו, בדיוק כפי שאתם עושים עם קובצי
.testו-.stories).גישת per-component מונעת מסוכני AI את הצורך לקפוץ בין כל הקבצים השונים. היא מרכזת את כל התרגומים במקום אחד, ובכך מגבילה את מורכבות המשימה ואת כמות ה-tokens הנצרכת.
מגבלות
כמובן, לגישה זו יש גם פשרות:
- היא עשויה להקשות על חיבור למערכות l10n חיצוניות ולכלים נוספים.
- נוצרת תלות בספרייה (lock-in), מה שקיים למעשה בכל פתרון i18n בשל התחביר הייחודי שלו.
זו הסיבה שבגללה Intlayer מנסה לספק סט כלים מלא עבור i18n (חינמי ובקוד פתוח לחלוטין), כולל תרגום מבוסס AI באמצעות ספק ה-AI ומפתחות ה-API שלכם. Intlayer מספקת בנוסף כלים לסנכרון קובצי ה-JSON שלכם, המתפקדים בדומה למעבדי הודעות של ICU / vue-i18n / i18next כדי למפות את התוכן לפורמטים הספציפיים שלהם.
תגובות
עדיין אין תגובות. היו הראשונים לשתף את מחשבותיכם.