
使用您最喜欢的AI助手总结文档,并引用此页面和AI提供商
此页面的内容已使用 AI 翻译。
查看英文原文的最新版本如果您有改善此文档的想法,请随时通过在GitHub上提交拉取请求来贡献。
文档的 GitHub 链接复制文档 Markdown 到剪贴板
如何选择合适的 React i18n 库
React 本身并没有提供内置的 i18n 原语。你在项目第一天选择的库,将决定翻译如何存储、如何打包进 bundle,以及未来几年需要承担多少维护工作。大多数团队通常根据流行度来选型,随后在翻译键达到 2,000 个时才发现各种妥协与限制。
本指南采用另一种思路:先回答关于你项目的几个核心问题,然后将答案映射到最契合的库。本文重点关注纯 React 生态(Vite、React Router、TanStack Start)。Next.js 有其专属的约束,已在 Next.js 对比文章 中详细介绍。

目录
在对比各库之前需要回答的 6 个问题
如果不清楚哪些指标对你最重要,功能对比表格就毫无意义。请先梳理以下问题:
- 应用采用何种渲染方式? 纯 SPA、带 hydration 的 SSR,还是 React Server Components。基于 Context 的 Hook 在 SPA 中处处适用;但在 RSC 中,Hook 会强制要求渲染文本的每个组件都加上
"use client",因此你还需要服务端 API。 - 谁来编写翻译? 开发者、使用 TMS 的内部团队、交付 ICU 文件的翻译公司,还是 AI 自动化流程。这比任何 API 细节都更能决定翻译目录的格式。
- 有多少个语言环境和页面? 2 个语言环境和 5 个页面完全可以一次性打包所有内容;10 个语言环境和 50 个路由则无法承受,加载策略将成为核心成本。
- 翻译键是否需要强类型约束? 在所有基于键的库中,
t("checkout.totl")中的拼写错误都能通过编译,除非你手动配置类型。评估团队是否能接受这一点。 - 文案包含哪些内容? 纯文本、复数形式,还是中间嵌入
<Link>的复杂句子。富文本内容往往是多数 API 变得臃肿的地方。 - 项目的生命周期有多长? 一个 3 个月的原型项目和一个维护 5 年的产品,对构建工具链的需求完全不同。
写下你的答案,后文的所有分析都将围绕它们展开。
一图看懂技术演进版图
十五年的 JavaScript i18n 发展史可以归纳为四波架构浪潮,而你所对比的 React 库正来自于不同的阶段。

在内存中加载 JSON 目录,运行时查找 t("a.b"),并在浏览器中解析 ICU 或自定义语法。生态最庞大,运行时最重,类型支持为 opt-in(可选配置)。
在构建时提取文案并编译为紧凑目录,提供类型化参数。通过增加额外的构建步骤(extract、compile)换取更小的 bundle 体积。
围绕 SSR 和 Server Components 设计。在服务端完成渲染,客户端仅 hydrate 必需的内容。本质上仍然基于键且集中管理。
文案被编译为支持 tree-shaking 的函数或按组件划分的字典。类型自动生成,缺失翻译直接中断构建,并通过 CLI 执行 AI 翻译。
JavaScript i18n 历史 详细探讨了每一波浪潮是如何解决前一波痛点的。
最关键的抉择:内容存放在哪里以及何时加载
所有 React i18n 库都具备相似的结构:一个 store、一个 provider、一个 hook。Provider 接收的任何内容最终都会进入客户端 bundle 或 hydration payload 中。因此,两个根本性的架构选择是:
- 集中式还是局部作用域内容: 整个应用共用一个
en.json,还是每个组件(或每个 namespace)独立声明。 - 静态导入还是动态导入: 启动时打包所有内容,还是按需获取当前语言环境与路由的内容。
下图估算了包含 1 到 10 个页面、翻译成 1 到 10 个语言环境、每页约 30 KB 文本的理论应用 payload:
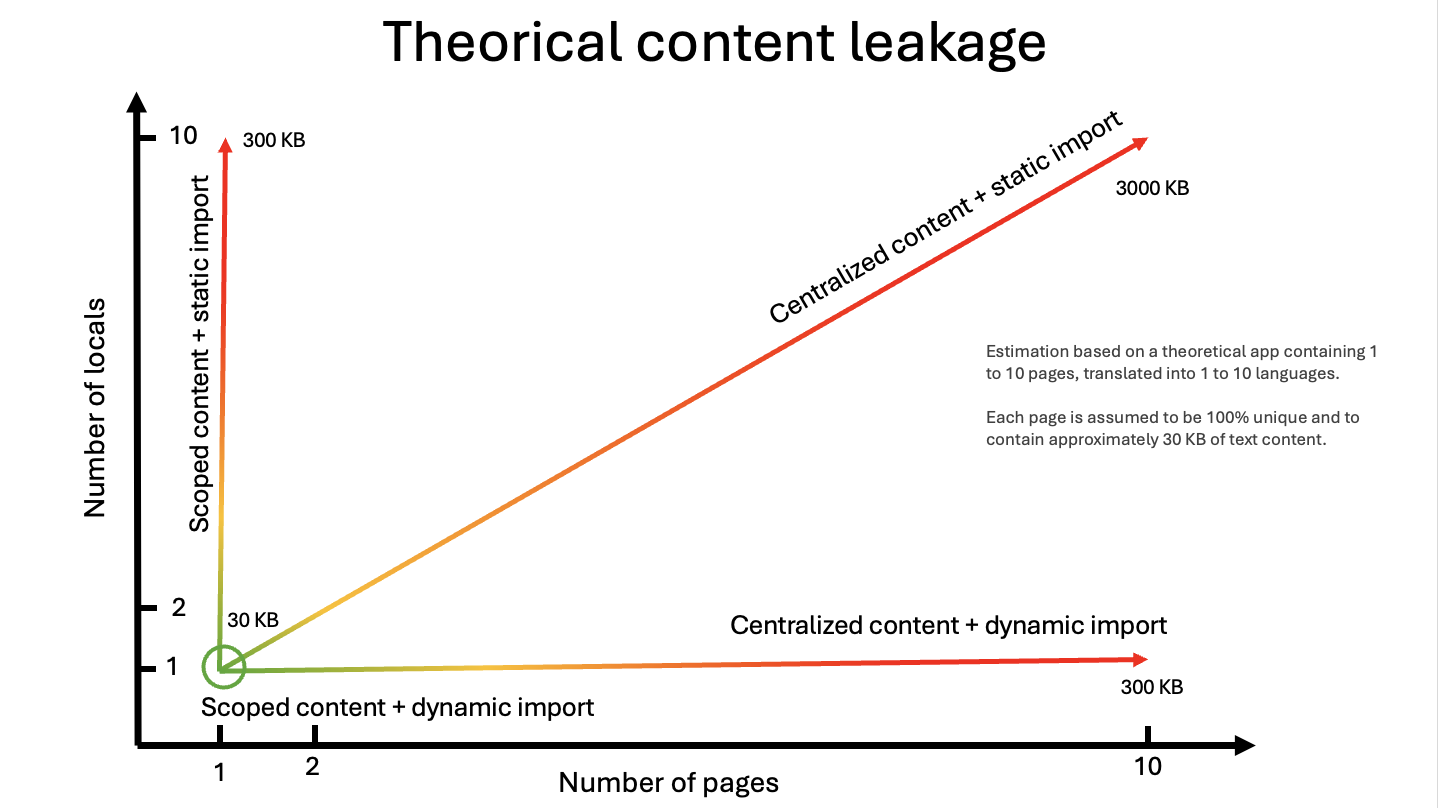
采用静态导入的集中式内容会随着两个维度同时膨胀:10 个页面乘以 10 个语言环境,意味着每个页面都要加载 300 KB 的文本。动态导入消除了语言维度的膨胀,组件级作用域消除了页面维度的膨胀,只有两者结合才能让体积保持平稳。
这不仅是库的特性,更关乎工程规范。react-i18next 可以通过 namespace 和 lazy backend 实现作用域划分,use-intl 也可以按路由拆分。但工具链本身并不会强制执行,一个通用的 <Button> 如果调用了 t("common:cta"),就会悄悄让 common 成为所有路由的依赖。基准测试 将这种现象衡量为“其他路由泄漏”和“其他语言泄漏”,这也是各库之间体积差距的主要来源。
如果你对第 3 个问题的答案是“多语言、多页面”,请将本节作为核心考量。按组件 vs 集中式 i18n 一文深入分析了这一选择在维护层面的影响。
候选方案一览
各库的体积数据来源于 TanStack Start 基准测试:空组件中的 provider 加上 hook,在经过打包、tree-shaking 和压缩后的体积(基于 10 个页面和 10 个语言环境)。内容体积单独计算。
在弹窗中打开表格以清晰地查看所有数据
| 库 | 演进浪潮 | 内容模型 | 键类型支持 | 消息格式 | 库体积 |
|---|---|---|---|---|---|
react-i18next | 运行时 | 集中式 JSON,namespaces | Opt-in (CustomTypeOptions) | i18next (后缀复数) | ~18.4 kB |
react-intl (FormatJS) | 运行时 | 集中式 JSON,ICU | Opt-in (提取 + union) | ICU | ~15.3 kB |
use-intl | 服务端优先 | 集中式 JSON,ICU | Opt-in (declaration merging) | ICU | ~14.1 kB |
@tolgee/react | 运行时 | 集中式,上下文内可视化编辑 (in-context) | 无 | ICU | ~11.1 kB |
| Lingui | 宏 | 代码内源码文本,编译后目录 | 良好,由编译器生成 | 基于宏的 ICU | 较小 |
| Paraglide | 编译器 | inlang 项目,生成函数 | 自动生成 | 自研格式 | 接近于零 |
| Intlayer | 编译器 | 单组件 .content.ts 声明 | 自动生成,默认开启 | 辅助工具 (plural, enu) | Baseline |
数据为基准测试特定版本时的快照,会随版本更新而变动。在仅凭体积做决定前,建议在自己的应用中运行基准测试。
表格中未体现的两点细节:Paraglide 本身体积接近于零,是因为它将代码直接生成到你的代码库中,这意味着每次 commit 前都需要重新生成,并且生成的文件可能产生 merge conflict;而 Intlayer 依赖打包工具插件(vite-intlayer 或等效插件),因此无法在无需构建工具(no-build)的环境中运行。
根据你的答案匹配合适的库
选择最简单能用的方案,避免过度投入。react-i18next 配合每个语言一个单独的 JSON 文件即可满足需求,Stack Overflow 上十年的积累能帮你节省大量时间。在真正需要前无需引入 namespaces。如果原型后续演进为正式产品,可以规划迁移到作用域隔离的内容管理;react-i18next 兼容适配器 支持渐进式迁移。
翻译目录格式已经预先确定。react-intl 原生支持 ICU,FormatJS 的提取工具专为该流程构建。use-intl 同样读取 ICU。react-i18next 则需要安装 ICU 插件,否则只能使用自有的复数键规则。Intlayer 的 ICU 支持仍在完善中,如果你当前依赖 ICU 字符串,建议将其作为关键考量项。
优先默认采用作用域隔离内容与动态加载,而不是依赖开发约定。Lingui 和 Paraglide 通过编译实现这一点。Intlayer 通过按组件声明实现,编译器仅打包当前路由渲染的内容。如果选用 react-i18next 或 use-intl,必须在第一天规划好 namespace 和懒加载策略并在 code review 中严格把关,因为工具链不会自动拦截违规引入。
所有基于键的库都可以配置类型,但几乎没有哪个是默认启用的。如果你不想维护在懒加载 namespaces 下脆弱的 declaration merging,请选择能从内容自动生成类型的库:Lingui、Paraglide 或 Intlayer。检测缺失翻译 一文对比了各工具在构建时能捕获的错误类型。
富文本节点是 t() 返回字符串模式的短板所在。react-i18next 和 Lingui 提供了 <Trans>,react-intl 提供了富文本标签,这些处理方式都比普通字符串更繁琐。Intlayer 的内容节点可直接接收 JSX、markdown 和嵌套对象,如果内容不仅限于简单 UI 标签,这种方式更为契合。
集中式 JSON 不再是刚需,因为无需导入到传统 TMS 中。代码就近放置的内容(colocated content)加上自动填充缺失语言的 CLI 是更高效的路径。Intlayer 的 fill 命令直接使用你自己的 API key(OpenAI、Anthropic、Mistral、Gemini),并且只翻译变更的内容。Paraglide 和 Tolgee 则提供了对应的托管版商业方案。
React context 无法跨越服务端/客户端边界。仅依赖客户端 Hook 构建的库(react-i18next、react-intl)在引入 RSC 时需要配套的服务端 API。use-intl(作为 next-intl)和 Intlayer(作为 next-intlayer)已经实现了这种架构拆分。在统一规范前,建议阅读 Next.js i18n 指南。
各个库的局限性
客观分析每个方案都存在的局限:
react-i18next:同类中最重,自研的复数格式,类型需手动配置与维护,废弃的无用键容易在无感知中堆积。react-intl:DX 较为繁琐(先useIntl()再formatMessage({ id })),全局实例绑定了较多节点。use-intl:上手简单,优化困难。Namespaces、动态加载与类型结合使用时会显著拖慢开发节奏。Lingui:需要额外的extract/compile构建步骤,多种并存的语法(t()、标签模板、i18n.t()、<Trans>)容易让开发者和 AI 助手产生混淆。Paraglide:在仓库中生成大量代码文件,在 React 基准测试中 tree-shaking 未充分生效,且语言环境直接从 storage 读取而非统一 store。Tolgee:缺乏键类型支持,上手门槛较高,核心卖点在上下文内可视化编辑。Intlayer:必须依赖构建插件,生态相对较新,ICU 支持尚不完整,内容天然分散在代码库中,若需为外部翻译人员导出单个全量 JSON 需要借助工具。gt-react,lingo.dev:在基准测试中表现欠佳:构建时容易出现配额错误、厂商锁定风险,以及需要强制刷新 provider 的响应性问题。
代码示例对比
以同一个组件(包含标题和复数统计的购物车摘要)为例,展示各个候选方案的实现。重点不仅在于组件代码,更在于内容如何存储以及类型检查器对内容的感知能力。
复制代码到剪贴板
复制代码到剪贴板
复数是基于 Intl.PluralRules 解析的后缀键。除非声明了 CustomTypeOptions,否则 t 的类型签名仅为 (key: string) => string,t("titel") 也能通过编译。
复制代码到剪贴板
复制代码到剪贴板
端到端采用 ICU 格式,这也是大多数 TMS 平台导出的标准格式。id 上的类型来自于 formatjs 提取步骤和生成的 union 类型,并非开箱即用。
复制代码到剪贴板
复制代码到剪贴板
结构与 next-intl 一致,但移除了 Next.js 专属绑定。使用 messages 类型扩展 AppConfig 后可获得键类型支持;namespaces 的拆分需要开发者自行规划。
复制代码到剪贴板
复制代码到剪贴板
源语言直接编写在组件中;其他语言在执行 lingui extract 后存放于带哈希 id 的 .po 文件中。如果遗漏了 extract 或 compile,会静默回退到英文。
复制代码到剪贴板
复制代码到剪贴板
每条消息都是自动生成的类型化函数,因此缺失键会直接触发导入错误。paraglide/ 目录直接生成在项目中,并在每次修改时重新生成。
复制代码到剪贴板
复制代码到剪贴板
所有语言环境集中在组件同级的单个文件中。类型在构建时自动生成,title 具备自动补全,拼写错误无需 declaration merging 即可在 tsc 中报错。删除组件目录即可同步删除对应文案。
如果已经在使用 react-i18next、react-intl 或 Lingui,兼容适配器(react-i18next、react-intl、Lingui)会在打包工具层面设置别名,让你在逐个迁移组件的同时保持现有 API 正常工作。迁移指南 涵盖了其余迁移步骤。
最终决定前的自查清单
功能清单仅说明库当前能做什么,以下几点则决定了长期维护的实际体验。
检查仓库活跃度。
关注 commit 频率、issue 响应速度,以及最近的小版本更新是否发生在今年。一个设计精良但缺乏维护的库,意味着未来不可避免的重构与迁移。
不要单纯依据 npm 下载量做决定。
安装量最大的往往是最早发布的库,而不一定是最适合 2026 年 React 代码库的方案。下载量衡量的是历史沉淀,而不是当下的契合度。
了解维护者的资金来源和商业模式。
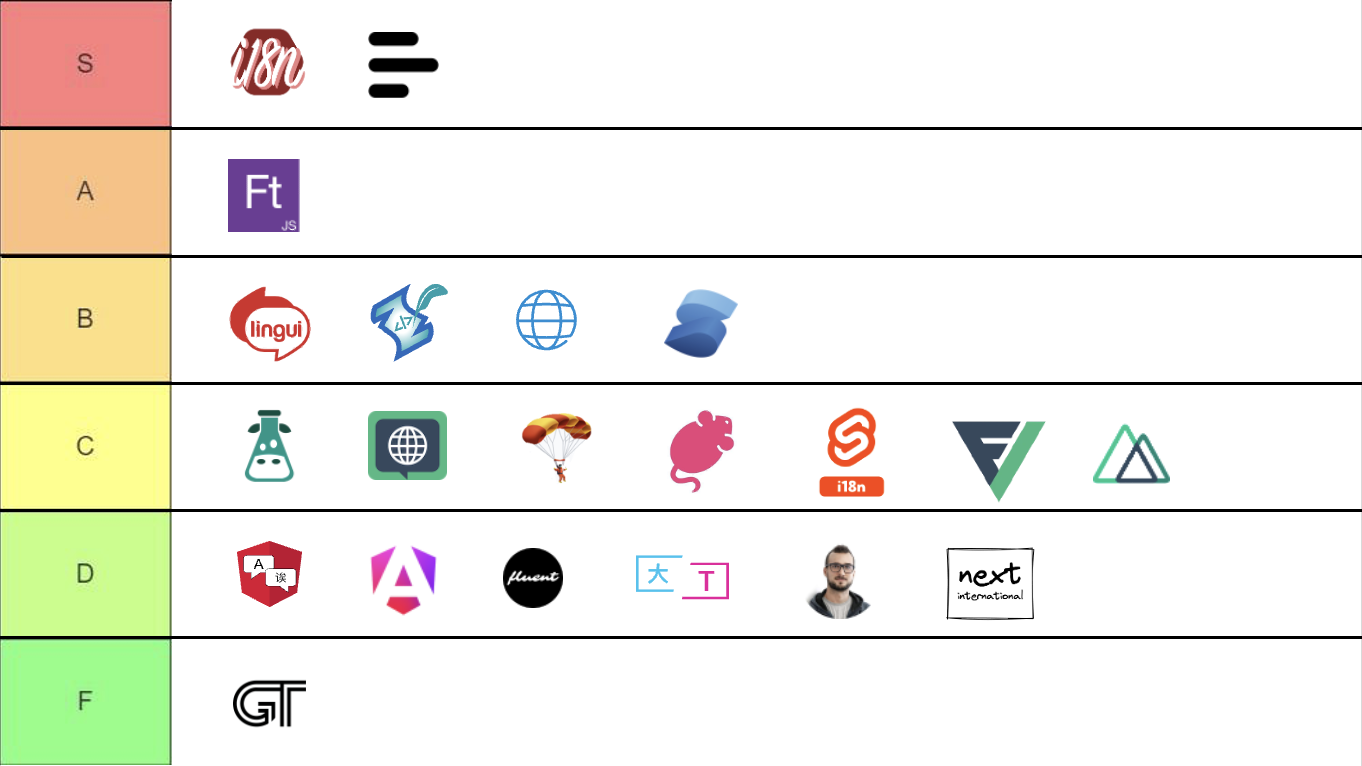
i18next 背后有 Locize 支持;next-intl / use-intl、vue-i18n、svelte-i18n 和 Lingui 由 Crowdin 支持;Tolgee、Paraglide (inlang) 和 Intlayer 则运营着各自的平台。靠托管翻译盈利的商业公司,通常缺乏动力在你的本地工具链内提供完全免费的翻译能力。Intlayer 是其中唯一支持直接通过 CLI 调用自带 API key(OpenAI、Anthropic、Mistral、Gemini)执行 AI 翻译并提供可私有化部署 CMS 的方案。
是否具备 AI Agent 就绪能力?
目前的 AI Agent 在处理 i18n 时仍容易出错:遗漏语言、凭空捏造键名、混淆消息语法。该库是否提供了 Agent Skills 或 MCP server,以便 Agent 可以列出、填充和测试文案?内容加载策略是开箱即优化的,还是需要每季度人工审核 namespaces 和懒加载导入?
开箱即用的类型安全。
关注的不是“通过额外配置能否支持类型”,而是“在全新安装后输入错误键名能否直接导致 tsc 报错”。测试访问不存在的键或某一语言缺少某条翻译时的行为表现。
废弃与未引用内容的检测。
翻译目录往往只增不减。Intlayer 构建时会自动清除未使用的字段并输出日志(build.purge)。Paraglide 依托架构天然支持,未被调用的消息函数会被 tree-shake 剔除。其他方案则需要开发者手动清理。
开发者体验 (DX)。
从零配置到渲染出第一条翻译字符串所需的时间、显示悬停翻译并支持跳转到声明的 LSP 或 VS Code 插件、用于填充、测试和推送的 CLI,以及非开发人员无需提交 PR 即可编辑文案的渠道(可视化编辑器 或 CMS)。
常见问题解答
对于大多数团队而言依然如此。它拥有最庞大的生态系统和最丰富的在线解决方案。它的成本真实存在但可预期:最大的运行时开销、自定义的复数格式,以及需要团队自行配置和维护的类型安全与作用域隔离。
只有当 bundle 体积、生成的类型或构建时缺失键检查是核心诉求时才需要。对于仅有两种语言的小型应用,运行时方案更为简单。编译器 vs 声明式 i18n 一文解析了编译器的优势以及可能存在的边界问题。
部分可以。基于键的库具有相似的 API 结构,可以通过兼容适配器将一个 API 别名映射到另一个 API(如 Intlayer 适配器的实现方式)。但消息格式(ICU、i18next、辅助函数)无法自动转换,因此复数和插值语法部分需要手动调整。
会产生间接影响。搜索引擎爬虫获取的内容由路由设计、hreflang、<html lang> 以及文本是否包含在服务端渲染的 HTML 中决定。部分库提供了相关辅助工具,大多数则需要开发者自行处理。详情参见 hreflang 指南。
延伸阅读
评论
暂无评论。成为第一个分享您想法的人吧。